OpenACC ディレクティブによるプログラミング(Update)
HPCWORLDの技術情報として、(旧)PGIコンパイラを利用したOpenACC によるGPUプログラミング情報が公開されています (OpenACC ディレクティブによるプログラミング by PGI Compilers (hpcworld.jp))、これは多くの読者がありとても有益な情報ですが、現在はNVIDIA HPC SDKのコンパイラが提供されています。今回プロメテックのメンバでOpenACCの利用事例をNVIDIA HPC SDKで利用してみました。従来のオプションが継続して利用できる一方で、NVIDIAのオプションの名称がついており、これから利用される方は新しいオプションを利用するのが良いと思います。
これからOpenACCを利用されようという方のお役に立てれば幸いです。
新1章(旧4章) OpenACC を使って、まず始めてみよう
1. 最初の心構え
簡単な C と Fortran プログラムを使って、OpenACC によるプログラミングを体験してみる。さらに、実際に GPU を使って実行を行う。OpenACC プログラミングにおいて最も大事な点を最初に述べよう。それは、ホストとアクセラレータ(デバイス)間のデータ転送を行う場所をプログラム上で明示しなければ、実行時に非常に時間が掛かる場合があるということである。プログラムの並列化部分の処理は、基本的にコンパイラに任せればよい。これに関して大きな労力はほとんどない。OpenACC においてプログラマが取り組むべき重要なタスクは、「データ転送を行う場所」をプログラム上で明示的に指示することだ。予め、この点を理解して OpenACC のプログラミングに臨む必要がある。
この章では単純なプログラム例を取り上げ、OpenACC の「並列マッピング用のディレクティブ」と「データコピーのためのディレクティブ」の二つを大まかに理解する。そして、旧第 2 章で述べられていた「CPU+アクセラレータ構成における性能のボトルネック部分」に関して、どのような方策をとれば両者間のデータコピーを極小化できるかも理解する。ここで使用した機材等を以下に示す。
| 使用した機材、ソフトウェア |
|---|
| コンパイラ |
| NVIDIA HPC SDK 22.5 |
| NVIDIA CUDA ソフトウェア環境 |
| CUDA 11.7 |
| OS |
| Rocky Linux release 8.6 (Green Obsidian) = Red Hat EL 8.6 |
| ハードウェア |
| Intel® Xeon® W-2123 CPU @ 3.60GHz / 4 cores |
| GPU |
| NVIDIA Quadro GV100 (Volta) with CUDA 11.7 driver |
2. nvaccelinfo コマンドで GPU のプロパティを見る
SDKのコマンドに nvaccelinfo がある。このコマンドを実行すると、以下に示すように搭載されている GPU(アクセラレータ)のハードウェア・プロパティの内容が表示される。複数のデバイスが搭載されていれば論理デバイス番号と共に、各デバイスの詳細が順番に表示される。
[abe@gv100-ws ~]$ nvaccelinfo CUDA Driver Version: 11070(GPU ソフトウェア・ドライバーのバージョン) NVRM version: NVIDIA UNIX x86_64 Kernel Module 515.48.07 Fri May 27 03:26:43 UTC 2022 Device Number: 0 Device Name: Quadro GV100 Device Revision Number: 7.0 Global Memory Size: 34087239680 Number of Multiprocessors: 80 Concurrent Copy and Execution: Yes Total Constant Memory: 65536 Total Shared Memory per Block: 49152 Registers per Block: 65536 Warp Size: 32 Maximum Threads per Block: 1024 Maximum Block Dimensions: 1024, 1024, 64 Maximum Grid Dimensions: 2147483647 x 65535 x 65535 Maximum Memory Pitch: 2147483647B Texture Alignment: 512B Clock Rate: 1627 MHz Execution Timeout: No Integrated Device: No Can Map Host Memory: Yes Compute Mode: default Concurrent Kernels: Yes ECC Enabled: Yes Memory Clock Rate: 850 MHz Memory Bus Width: 4096 bits L2 Cache Size: 6291456 bytes Max Threads Per SMP: 2048 Async Engines: 2 Unified Addressing: Yes Managed Memory: Yes Concurrent Managed Memory: Yes Preemption Supported: Yes Cooperative Launch: Yes Multi-Device: Yes Default Target: cc70(このデバイスに対するNVIDIAコンパイラオプション) |
3. 簡単なラプラス方程式のプログラム
GitHub に、C 言語で書いた簡単なラプラス方程式をヤコビ法で解くプログラムがある。今回はこのプログラムを利用することにする。プログラムは、以下のサイトから入手出来る (Apache License)。
https://github.com/parallel-forall/cudacasts/tree/master/ep3-first-openacc-program
ここでは、このソースを元に以下のベース・プログラムを作成した。なお、NVIDIA C コンパイラは C11 準拠のコンパイラであり、デフォルトで C11 構文を解釈する。C/C++特有のコンパイラオプションに関してはこちらを参照。
     1	/*
     2	 *  Copyright 2012 NVIDIA Corporation
     3	 *
     4	 *  Licensed under the Apache License, Version 2.0 (the "License");
     5	 *  you may not use this file except in compliance with the License.
     6	 *  You may obtain a copy of the License at
     7	 *
     8	 *      http://www.apache.org/licenses/LICENSE-2.0
     9	 *
    10	 *  Unless required by applicable law or agreed to in writing, software
    11	 *  distributed under the License is distributed on an "AS IS" BASIS,
    12	 *  WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
    13	 *  See the License for the specific language governing permissions and
    14	 *  limitations under the License.
    15	 */
    16
    17	#include
    18	#include
    19	#include "timer.h"
    20
    21	#define NN 4096
    22	#define NM 4096
    23
    24	double A[NN][NM];
    25	double Anew[NN][NM];
    26
    27	int main(int argc, char** argv)
    28	{
    29	    const int n = NN;
    30	    const int m = NM;
    31	    const int iter_max = 1000;
    32
    33	    const double tol = 1.0e-6;
    34	    double error     = 1.0;
    35
    36	    memset(A, 0, n * m * sizeof(double));
    37	    memset(Anew, 0, n * m * sizeof(double));
    38
    39	    for (int j = 0; j < n; j++)
    40      {
    41         A[j][0] = 1.0;
    42         Anew[j][0] = 1.0;
    43      }
    44
    45      printf("Jacobi relaxation Calculation: %d x %d mesh\n", n, m);
    46
    47      StartTimer();
    48      int iter = 0;
    49
    50      while ( error > tol && iter < iter_max )
    51	    {
    52	        error = 0.0;
    53
    54	        for( int j = 1; j < n-1; j++)
    55	        {
    56	            for( int i = 1; i < m-1; i++ )
    57	            {
    58	                Anew[j][i] = 0.25 * ( A[j][i+1] + A[j][i-1]
    59	                                    + A[j-1][i] + A[j+1][i]);
    60	                error = fmax( error, fabs(Anew[j][i] - A[j][i]));
    61	            }
    62	        }
    63
    64	        for( int j = 1; j < n-1; j++)
    65	        {
    66	            for( int i = 1; i < m-1; i++ )
    67	            {
    68	                A[j][i] = Anew[j][i];
    69	            }
    70	        }
    71
    72	        if(iter % 100 == 0) printf("%5d, %0.6f\n", iter, error);
    73
    74	        iter++;
    75	    }
    76
    77	    double runtime = GetTimer();
    78
    79	    printf(" total: %f s\n", runtime / 1000);
    80	    exit(0);
    81	}
|
順番に OpenACC ディレクティブを挿入した効果とその結果を示すために、以下のソースプログラムを作成した。また、同じ内容の Fortran ソースプログラムも作成した。各ソースファイルは、これから説明する順番に suffix が付いている。なお、C プログラムのコンパイル時は、timer.h ファイルが必要となるため、これをソースファイルと同じ directory に置いておくこと。以下に述べる事例は、全て Linux 上で実施した際の様子を示したものである。
| 内容 | C | Fortran |
|---|---|---|
| (1) CPU用のベースプログラム | laplace0.c | laplace0.f90 |
| (2) OpenACC のループ並列化用ディレクティブ挿入 | lapace1.c | laplace1.f90 |
| (3) OpenACC のデータ・ディレクティブ挿入 | lapace2.c | laplace2.f90 |
| C プログラム用ヘッダーファイル | timer.h | — |
4. CPU 上での実行
laplace0.c と laplace0.f90 をコンパイルして CPU 上で実行を行ってその時間を把握する。-fast 最適化オプションを適用して、SIMD ベクトル化を実施した性能を取得する。以下の C の場合と Fortran の場合を示したが、このプログラムにおいては、Fortran コーディングの方が速い。いずれも1コアを使用して実行した結果である。
• C プログラムの場合
[abe@gv100-ws ~]$ nvc -fast -Minfo laplace0.c -o laplace0-C (コンパイル・リンク) GetTimer: main: 40, Loop not fused: function call before adjacent loop Loop not vectorized: unprofitable for target Loop unrolled 8 times 48, StartTimer inlined, size=2 (inline) file laplace0.c (38) 57, Generated vector simd code for the loop containing reductions 63, FMA (fused multiply-add) instruction(s) generated 67, Memory copy idiom, loop replaced by call to __c_mcopy8 78, GetTimer inlined, size=9 (inline) file laplace0.c (55) [abe@gv100-ws ~]$ ./laplace0-C (実行) Jacobi relaxation Calculation: 4096 x 4096 mesh 0, 0.250000 100, 0.002397 200, 0.001204 300, 0.000804 400, 0.000603 500, 0.000483 600, 0.000403 700, 0.000345 800, 0.000302 900, 0.000269 total: 57.559759 s 57秒掛かる。 |
• Fortran プログラムの場合
[abe@gv100-ws ~]$ nvfortran -fast -Minfo laplace0.f90 -o laplace0-F
laplace:
     31, Memory zero idiom, array assignment replaced by call to pgf90_mzero8
     32, Memory zero idiom, array assignment replaced by call to pgf90_mzero8
     34, Loop not fused: function call before adjacent loop         Loop not vectorized: unprofitable for target
         Loop unrolled 8 times
     48, Generated vector simd code for the loop containing reductions
     56, Memory copy idiom, loop replaced by call to __c_mcopy8
[abe@gv100-ws ~]$ ./laplace0-F
 Time measurement accuracy : .10000E-05
 Jacobi relaxation Calculation:         4096  x          4096 mesh
            0   0.2500000000000000
          100   2.3970623764720811E-003
          200   1.2043203299441085E-003
          300   8.0370630064013904E-004
          400   6.0346074818462547E-004
          500   4.8300191812361559E-004
          600   4.0251372422966947E-004
          700   3.4514687472469996E-004
          800   3.0211701794469192E-004
          900   2.6855145615783949E-004
 total :     51.87104500000000      sec  51秒掛かる。。
|
5. OpenACC のループ並列化のためのディレクティブを適用する
さて、OpenACC ディレクティブを使ってみよう。一般的には、プログラム内で時間が掛かりそうなルーチンに目星を付け、その中で並列化可能なループを見つける。そして、このループに対して OpenACC ディレクティブを適用する。以下に、laplace1.c の主要部をリスティングの形 (-Mlistコンパイルオプション)で表示した。行番号 50 は while 構文で収束計算を行う外側の大きなループである。このループの中に、OpenACC 並列化対象となるループが複数存在している。行番号 55 と 66 は、2 重のネストループであり、このループ内はデータ依存性がないため並列化可能である。この二つのネストループの直前に、OpenACC kernels ディレクティブを挿入してみる。このディレクティブは、その直下のネストループを対象としてアクセラレータ用に並列化コード(カーネル)を作成するよう、コンパイラに指示するものである。最低限、この kernels ディレクティブを指示することで、コンパイラは自動的にアクセラレータの並列構造に応じた並列化マッピングを行い、当該カーネルコードを作成する。さらにもう一つ、コンパイラはアクセラレータ上で必要とされる「データ」を調べ、ホストとアクセラレータ間でデータのコピー(copyin/copyout) を行うためのコードも自動的に作成する。大きく言ってこの二つの機能がデフォルトで行う kernels ディレクティブの動作となる。注意すべき点は、コンパイラはその度にデータコピーを行うコードも必ず作成するという点にある。これが、場所によっては「データ転送の嵐」を引き起こす。このプログラムもこの問題に相当するものである。以下のコンパイル・メッセージを見て欲しい。プログラムの行番号と共に「並列化の箇所」と「データのコピーを行う配列名とそのサイズ」が表示されており、データ転送を行う場所が分かる。この場所は、while ループの内側にあるため、収束計算のためのイテレーション毎に必ず、データ転送のイベントが生じる形態となっている。これが性能的に問題となる。
• C プログラムの場合
ソースコード
( 50) while ( error > tol && iter < iter_max ) // 外側の収束計算のための反復ループ ( 51) { ( 52) error = 0.0; ( 53) ( 54) #pragma acc kernels //以下の nest loop の並列化コードとデータコピーのためのコードを作成する ( 55) for( int j = 1; j < n-1; j++) ( 56) { ( 57) for( int i = 1; i < m-1; i++ ) ( 58) { ( 59) Anew[j][i] = 0.25 * ( A[j][i+1] + A[j][i-1] ( 60) + A[j-1][i] + A[j+1][i]); ( 61) error = fmax( error, fabs(Anew[j][i] - A[j][i])); ( 62) } ( 63) } ( 64) ( 65) #pragma acc kernels //以下の nest loop の並列化コードとデータコピーのためのコードを作成する ( 66) for( int j = 1; j < n-1; j++) ( 67) { ( 68) for( int i = 1; i < m-1; i++ ) ( 69) { ( 70) A[j][i] = Anew[j][i]; ( 71) } ( 72) } ( 73) ( 74) if(iter % 100 == 0) printf("%5d, %0.6f\n", iter, error); ( 75) ( 76) iter++; ( 77) } |
コンパイル
[abe@gv100-ws ~]$ nvc -acc -fast -Minfo=accel laplace1.c -o laplace1-C main: 52, Generating implicit copyin(A[:][:]) [if not already present] データコピーコード生成 Generating implicit copy(error) [if not already present] Generating implicit copyout(Anew[1:4094][1:4094]) [if not already present] 55, Loop is parallelizable 「並列化可能であることを伝えているだけ」のメッセージ 57, Loop is parallelizable Generating NVIDIA GPU code 「並列化コード生成した」というメッセージ 55, #pragma acc loop gang, vector(128) collapse(2) /* blockIdx.x threadIdx.x */ Generating implicit reduction(max:error) 57, /* blockIdx.x threadIdx.x auto-collapsed */ 63, Generating implicit copyin(Anew[1:4094][1:4094]) [if not already present] Generating implicit copyout(A[1:4094][1:4094]) [if not already present] データコピーコード生成 66, Loop is parallelizable 並列化可能 68, Loop is parallelizable Generating NVIDIA GPU code 「並列化コード生成した」というメッセージ 66, #pragma acc loop gang, vector(128) collapse(2) /* blockIdx.x threadIdx.x */ 68, /* blockIdx.x threadIdx.x auto-collapsed */ |
この実行バイナリを実行すると、以下に示すとおり 114 秒掛かっている。アクセラレータ上で並列実行しているにもかかわらず、CPU の 1コアで実行した時の 57 秒よりも遅い。この理由は、while ループ 1 回毎に、A[] と Anew[] 配列のデータコピーが行われており、実行経過時間のほとんどをデータのコピーで消費しているからである。その様子を見てみよう。実行前に、SDK の環境変数 NVCOMPILER_ACC_TIME に 1 をセットしておくと、実行終了後に、アクセラレータの使用に関する性能プロファイル結果が出力される。まず、ここで気がつくことは、実測した経過時間が 114 秒にも拘わらず、簡易プロファイルの「Accelerator Kernel Timing data」が示す時間は、43 秒である。この差は何か?アクセラレータ・デバイス側で捕捉したプロファイル時間 43 秒は基本的に正しい。となると、114 – 43 = 71秒は CPU サイドで消費した経過時間となる。実はこの時間は CPU 側でデータを転送する際に生じるオーバーヘッドである。具体的に言えば、ホスト~デバイス間のデータ転送は、大きなデータをブロックに分けて、それを順番に送っている。転送はストリーム型で流れるわけではなく、ブロック間に何も転送処理を行っていない間隙が生まれる。この積算時間が 70 秒近くになっているということになる(なお、この時間の中には、NVCOMPILER_ACC_TIME をセットしてプロファイル情報を取得するためのオーバーヘッドも含まれる)。そもそも、データ転送回数が多いためこうしたオーバーヘッドも目立つ結果となっている。従って、データ転送を極力少なくするように、一度、アクセラレータ側に送ったデータはそこで常駐化してデータを使用することが必要となる。これが、アクセラレータを使う際のコツである。 以下のプロファイル情報の中に下線を引いたところがデバイス側で捕捉したデータコピーに関するプロファイル情報である。総計すると42秒、純粋にデバイスとの間でデータ転送に費やされていたことになる。それ以外は、アクセラレータ上での並列実行処理を行った時間であるため、高々1秒程度でこの処理が終わっていることになる。
(以下の環境変数は、実行時の簡易プロファイル情報を表示する際に 1 を指定 [abe@gv100-ws ~]$ export NVCOMPILER_ACC_TIME=1 [abe@gv100-ws ~]$ ./laplace1-C Jacobi relaxation Calculation: 4096 x 4096 mesh 0, 0.250000 100, 0.002397 200, 0.001204 300, 0.000804 400, 0.000603 500, 0.000483 600, 0.000403 700, 0.000345 800, 0.000302 900, 0.000269 total: 114.334734 s 全経過時間 (簡易プロファイル結果) Accelerator Kernel Timing data /home/abe/laplace1.c main NVIDIA devicenum=0 time(us): 43,643,286 GPUデバイス側で消費した経過時間 52: compute region reached 1000 times 57: kernel launched 1000 times grid: [65535] block: [128] device time(us): total=510,288 max=512 min=509 avg=510 elapsed time(us): total=537,509 max=560 min=534 avg=537 57: reduction kernel launched 1000 times grid: [1] block: [256] device time(us): total=126,923 max=130 min=125 avg=126 elapsed time(us): total=140,535 max=162 min=138 avg=140 52: data region reached 2000 times 52: data copyin transfers: 9000 9000回転送(論理的に分割したデータブロックの転送回数) device time(us): total=10,958,498 max=1,416 min=7 avg=1,217 63: data copyout transfers: 9000 device time(us): total=10,287,340 max=1,317 min=6 avg=1,143 63: compute region reached 1000 times 68: kernel launched 1000 times grid: [65535] block: [128] device time(us): total=496,285 max=503 min=495 avg=496 elapsed time(us): total=525,229 max=544 min=522 avg=525 63: data region reached 2000 times 63: data copyin transfers: 8000 device time(us): total=10,984,186 max=1,401 min=1,369 avg=1,373 72: data copyout transfers: 8000 device time(us): total=10,279,766 max=1,308 min=1,280 avg=1,284 |
NVIDIA/CUDA の場合、nvprofコマンドでプロファイリングを行う方法がある。もちろん、コマンドベース以外に従来の NVIDIA Visual Profiler も使用できる。ここでは、nvprof の例を以下に示す。実行前に、SDK の環境変数 NVCOMPILER_ACC_TIME に 0 をセットする。データのコピー(HtoD、DtoH)に関する時間、並列ループのカーネルが消費した時間が表示される。この結果でも、ほとんどがデータのコピーに関する時間となっていることが分かる。
[abe@gv100-ws ~]$ which nvprof
/opt/nvidia/hpc_sdk/Linux_x86_64/22.5/compilers/bin/nvprof
[abe@gv100-ws ~]$ export NVCOMPILER_ACC_TIME=0
[abe@gv100-ws ~]$ nvprof ./laplace1-C
Jacobi relaxation Calculation: 4096 x 4096 mesh
==33055== NVPROF is profiling process 33055, command: ./laplace1-C
    0, 0.250000
  100, 0.002397
  200, 0.001204
  300, 0.000804
  400, 0.000603
  500, 0.000483
  600, 0.000403
  700, 0.000345
  800, 0.000302
  900, 0.000269
 total: 96.484763 s
==33055== Profiling application: ./laplace1-C
==33055== Profiling result:
            Type  Time(%)      Time     Calls       Avg       Min       Max  Name
 GPU activities:   50.38%  21.8964s     16000  1.3685ms  1.3623ms  1.4025ms  [CUDA memcpy HtoD]
                   47.00%  20.4277s     17000  1.2016ms  1.2150us  1.2995ms  [CUDA memcpy DtoH]
                    1.20%  519.43ms      1000  519.43us  512.06us  521.34us  main_57_gpu
                    1.16%  505.22ms      1000  505.22us  496.89us  506.72us  main_68_gpu
      API calls:   72.43%  18.0235s     48996  367.86us     432ns  1.6595ms  cuEventSynchronize
                   25.76%  6.40975s      6000  1.0683ms  234.67us  1.4474ms  cuStreamSynchronize
OpenACC (excl):   25.44%  24.4860s      1000  24.486ms  24.252ms  25.335ms  acc_exit_data@laplace1.c:52
                   25.44%  24.4841s      1000  24.484ms  23.971ms  25.214ms  acc_exit_data@laplace1.c:63
                   18.76%  18.0581s      1000  18.058ms  17.854ms  18.799ms  acc_enter_data@laplace1.c:63
                   18.72%  18.0182s      1000  18.018ms  17.779ms  36.187ms  acc_enter_data@laplace1.c:52
                    5.04%  4.84814s      2000  2.4241ms  1.3507ms  3.6782ms  acc_wait@laplace1.c:63
                    3.61%  3.47897s      1000  3.4790ms  3.0813ms  3.6707ms  acc_wait@laplace1.c:72
                    1.41%  1.36107s      1000  1.3611ms  303.68us  1.4484ms  acc_wait@laplace1.c:52
(但し、1%未満の値のものについては省略した。)
|
• Fortran プログラムの場合
Fortranプログラムの例の場合は、上記 C プログラムの場合と同様な見方をすることが出来る。実際の作業としては、ソースコードのリスティング と-Minfo によるコンパイル・メッセージを見て、「データのコピーの場所」や「並列化対象部分」を確認する。実行においては、プロファイリングを行って、デバイス上での性能情報を確認するというのが、一般的な作業の手順となる。以下の内容に関する説明は、上述した C プログラムの場合と同様であるため、ここでは割愛する。
( 42) iter = 0 ( 43) do while ( iter .le. iter_max-1 .and. error .gt. tol ) ( 44) ( 45) error =0.d0 ( 46) !$acc kernels !以下の nest loop の並列化コードとデータコピーのためのコードを作成する ( 47) do j = 2, m-1 ( 48) do i = 2, n-1 ( 49) Anew(i,j) = 0.25 * ( A(i,j+1) + A(i,j-1) & ( 50) + A(i-1,j) + A(i+1,j) ) ( 51) error = max(error, abs(Anew(i,j) - A(i,j))) ( 52) end do ( 53) end do ( 54) !$acc end kernels !Fortranでは kernels directive の終了を指示する必要有り ( 55) ( 56) !$acc kernels !以下の nest loop の並列化コードとデータコピーのためのコードを作成する ( 57) do j = 2, m-1 ( 58) do i = 2, n-1 ( 59) A(i,j) = Anew(i,j) ( 60) end do ( 61) end do ( 62) !$acc end kernels ( 63) ( 64) if ( mod (iter,100) == 0 ) print *, iter, error ( 65) iter = iter + 1 ( 66) ( 67) end do |
[abe@gv100-ws ~]$ export NVCOMPILER_ACC_TIME=1 [abe@gv100-ws ~]$ nvfortran -acc -fast -Minfo=accel laplace1.f90 -o laplace1-F laplace: 46, Generating implicit copyin(a(:,:)) [if not already present] データコピーのコード生成 Generating implicit copyout(anew(2:4095,2:4095)) [if not already present] Generating implicit copy(error) [if not already present] Generating NVIDIA GPU code 並列化可能 48, Loop is parallelizable Generating NVIDIA GPU code 「並列化コード生成した」というメッセージ 47, !$acc loop gang, vector(128) collapse(2) ! blockidx%x threadidx%x Generating implicit reduction(max:error) 48, ! blockidx%x threadidx%x auto-collapsed 56, Generating implicit copyin(anew(2:4095,2:4095)) [if not already present] データコピーのコード生成 Generating implicit copyout(a(2:4095,2:4095)) [if not already present] 57, Loop is parallelizable 58, Loop is parallelizable Generating NVIDIA GPU code 57, !$acc loop gang, vector(128) collapse(2) ! blockidx%x threadidx%x 58, ! blockidx%x threadidx%x auto-collapsed [abe@gv100-ws ~]$ ./laplace1-F Time measurement accuracy : .10000E-05 Jacobi relaxation Calculation: 4096 x 4096 mesh 0 0.2500000000000000 100 2.3970623764720811E-003 200 1.2043203299441085E-003 300 8.0370630064013904E-004 400 6.0346074818462547E-004 500 4.8300191812361559E-004 600 4.0251372422966947E-004 700 3.4514687472469996E-004 800 3.0211701794469192E-004 900 2.6855145615783949E-004 total : 113.1626580000000 sec Accelerator Kernel Timing data /home/abe/laplace1.f90 laplace NVIDIA devicenum=0 time(us): 43,601,705 46: compute region reached 1000 times 48: kernel launched 1000 times grid: [65535] block: [128] device time(us): total=507,058 max=517 min=505 avg=507 elapsed time(us): total=534,506 max=552 min=530 avg=534 48: reduction kernel launched 1000 times grid: [1] block: [256] device time(us): total=127,348 max=129 min=125 avg=127 elapsed time(us): total=141,046 max=188 min=138 avg=141 46: data region reached 2000 times 46: data copyin transfers: 9000 device time(us): total=10,959,040 max=1,416 min=7 avg=1,217 54: data copyout transfers: 9000 device time(us): total=10,267,448 max=1,345 min=5 avg=1,140 56: compute region reached 1000 times 58: kernel launched 1000 times grid: [65535] block: [128] device time(us): total=496,253 max=500 min=495 avg=496 elapsed time(us): total=525,296 max=536 min=522 avg=525 56: data region reached 2000 times 56: data copyin transfers: 8000 device time(us): total=10,984,806 max=1,405 min=1,369 avg=1,373 62: data copyout transfers: 8000 device time(us): total=10,259,752 max=1,299 min=1,277 avg=1,282 (nvprof を使用してプロファイルを取得した例) [abe@gv100-ws ~]$ export NVCOMPILER_ACC_TIME=0 [abe@gv100-ws ~]$ nvprof ./laplace1-F Time measurement accuracy : .10000E-05 Jacobi relaxation Calculation: 4096 x 4096 mesh ==33092== NVPROF is profiling process 33092, command: ./laplace1-F 0 0.2500000000000000 100 2.3970623764720811E-003 200 1.2043203299441085E-003 300 8.0370630064013904E-004 400 6.0346074818462547E-004 500 4.8300191812361559E-004 600 4.0251372422966947E-004 700 3.4514687472469996E-004 800 3.0211701794469192E-004 900 2.6855145615783949E-004 total : 95.79224800000000 sec ==33092== Profiling application: ./laplace1-F ==33092== Profiling result: Type Time(%) Time Calls Avg Min Max Name GPU activities: 50.39% 21.8951s 16000 1.3684ms 1.3627ms 1.3971ms [CUDA memcpy HtoD] 47.01% 20.4262s 17000 1.2015ms 1.2150us 1.3009ms [CUDA memcpy DtoH] 1.19% 517.52ms 1000 517.52us 510.04us 520.22us laplace_48_gpu 1.16% 504.99ms 1000 504.99us 495.93us 506.65us laplace_58_gpu API calls: 72.43% 18.0235s 48996 367.86us 415ns 1.6635ms cuEventSynchronize 25.74% 6.40580s 6000 1.0676ms 213.23us 1.4524ms cuStreamSynchronize OpenACC (excl): 25.50% 24.3658s 1000 24.366ms 24.169ms 25.528ms acc_exit_data@laplace1.f90:46 25.48% 24.3476s 1000 24.348ms 24.086ms 29.766ms acc_exit_data@laplace1.f90:56 18.71% 17.8761s 1000 17.876ms 17.713ms 18.626ms acc_enter_data@laplace1.f90:56 18.63% 17.7973s 1000 17.797ms 17.608ms 34.573ms acc_enter_data@laplace1.f90:46 3.63% 3.46552s 1000 3.4655ms 3.0942ms 3.6777ms acc_wait@laplace1.f90:62 3.63% 3.46463s 1000 3.4646ms 3.1051ms 3.6866ms acc_wait@laplace1.f90:54 1.43% 1.36720s 1000 1.3672ms 1.3604ms 1.3854ms acc_wait@laplace1.f90:56 1.42% 1.35928s 1000 1.3593ms 302.79us 1.4537ms acc_wait@laplace1.f90:46 (但し、1%未満の値のものについては省略した。) |
6. OpenACC のデータ・ディレクティブを明示的に挿入する
• OpenACC data ディレクティブの役目
このステップでは、OpenACC モデルの本丸と言ってよい「データコピーを行う適切な場所」について考えてみる。デバイス(GPU)側の計算で必要な配列・データは while ループ実行前にデバイス側にコピーし常駐させ、while ループの内側の計算処理では、ホストとデバイス間でデータをコピーしないようにすると、上述 (2) で述べたような「データ転送の嵐」が避けられる。こうしたデータのコピーを行う場所の明示的な指定は、OpenACC data ディレクティブ(構文)を用いて行う。これを説明する前に、以下のポイントを理解しておいて欲しい。
- OpenACC の並列化を指示するためのディレクティブである kernels や parallel 構文の役目の一つは、その対象とするループ中で使用されている配列、スカラ変数を調べて、ホストとデバイス間のデータコピーを行うためのコード生成を「暗黙」に行うことである。従って、これらの構文を指定するとデフォルトの動作として、ホストとデバイス間のデータコピーを必ず行う。
- その際に用いている「データのコピーの方法」のデフォルトは、OpenACC data 構文の clause(節) である copy 節、copyin 節、copyout 節、create 節のいずれかを使用している。これらの挙動は、コピーの対象となる配列が「アクセラレータ上のメモリ」上にアロケートされているかどうかのチェックを行い、その正否でデータコピーを行うかの判断を行うといったものである。事前に、かつ明示的に data 構文を用いてデータのアロケートとコピーを実施している場合に限り、kernels や parallel 構文の時点におけるデータコピーは行わない。この場合、アクセラレータ側では、すでにデバイス上にアロケートされているデータを使用して処理を行う形となる。
- ループ内にデータのコピーを伴う kernels や parallel 構文が配置される場合は、当該ループの外側で予め必要なデータの領域をアロケートし、コピーしておく必要がある。これを行うのが data ディレクティブの役目である。
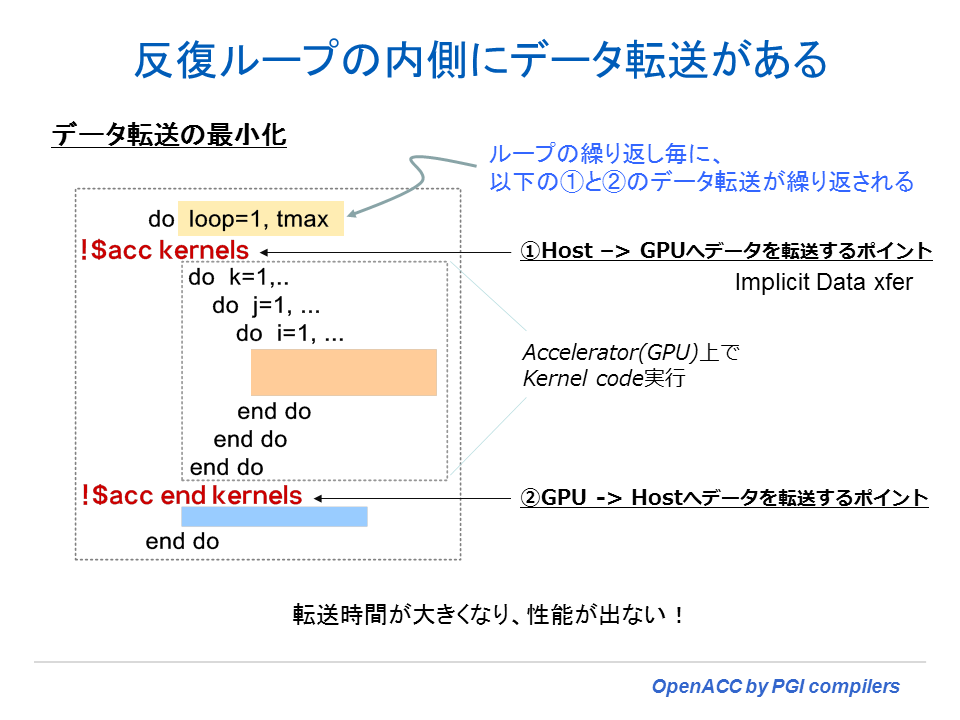
以下に、説明した内容を具体的に図で表した。外側の loop ループの中に、kernels ディレクティブが存在している。この場合は、loop ループの周回毎に、kernels が生成した「データコピー」が実行される。データ転送の嵐となる。
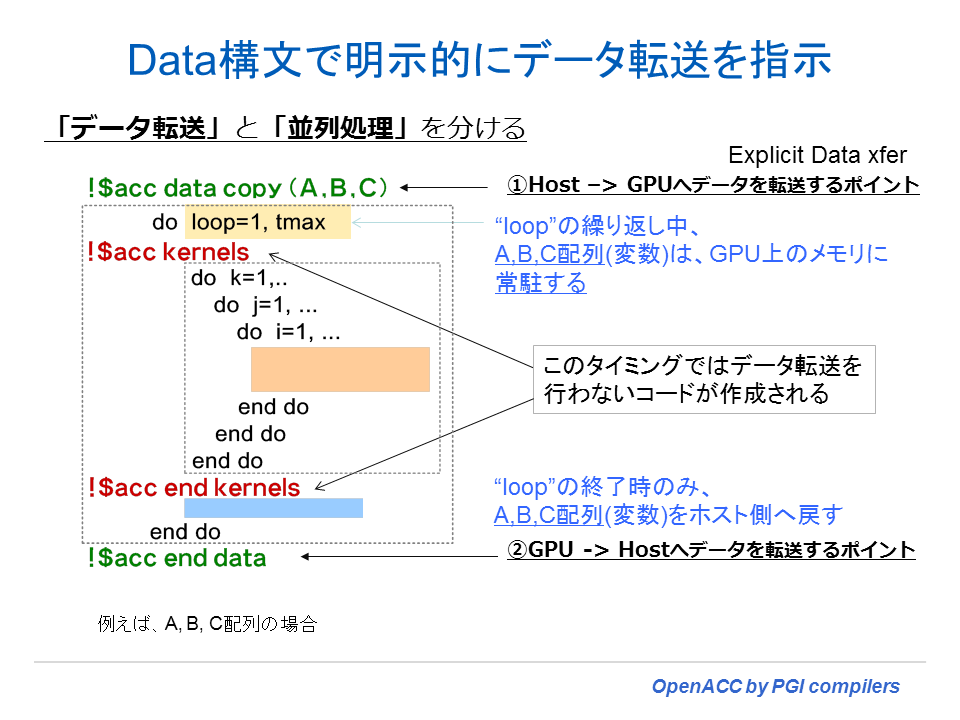
一方、外側のループの前に、data 構文を使い、当該ループ内で使用される配列のコピー属性を指定すると、この時点で、必要とする配列データのアロケートとホスト~デバイス間のデータ転送処理を行う。外側ループの内部の kernels 構文指定場所においては、データコピーは発生せず、すでにアクセラレータ側にあるデータを使用するようになる。そして外側ループの終端で、ホスト側で必要とされるデータがデバイス側からコピーされると言う形となる。
• C プログラムの場合
OpenACC data ディレクティブを使用して、データ転送を行う場所を変更したプログラムを以下に示す。(2) で述べたプログラムに、以下の 50行目で示す 1 行だけ追加しただけである。while ループの直前に A 配列をデバイス側にコピーして、かつ、while ループが終了した時点で、A 配列の内容をデバイス側からホスト側に戻すと言う指示が #pragma acc data の copy(A) 節の表す意味となる。もう一つ、create(Anew) と言う節は、ホスト側~デバイス間のデータコピーは発生しないが、デバイス側に Anew 配列の領域をアロケートして、デバイス上の一時的配列として使いなさいと言う意味となる。下記のプログラムを見て、Anew 配列は、確かに一時的に使用する配列であり、これはデバイス上にのみ存在すればよいものであることが分かる。
(   50) #pragma acc data copy(A), create(Anew)
                      // while ループの前に A[] とAnew[] 配列のアロケート&コピーを行う
(   51)     while ( error > tol && iter < iter_max )
(   52)     {
(   53)         error = 0.0;
(   54)
(   55) #pragma acc kernels
(   56)         for( int j = 1; j < n-1; j++)
(   57)         {
(   58)             for( int i = 1; i < m-1; i++ )
(   59)             {
(   60)                 Anew[j][i] = 0.25 * ( A[j][i+1] + A[j][i-1]
(   61)                                     + A[j-1][i] + A[j+1][i]);
(   62)                 error = fmax( error, fabs(Anew[j][i] - A[j][i]));
(   63)             }
(   64)         }
(   65)
(   66) #pragma acc kernels
(   67)         for( int j = 1; j < n-1; j++)
(   68)         {
(   69)             for( int i = 1; i < m-1; i++ )
(   70)             {
(   71)                 A[j][i] = Anew[j][i];
(   72)             }
(   73)         }
(   74)
(   75)         if(iter % 100 == 0) printf("%5d, %0.6f\n", iter, error);
(   76)
(   77)         iter++;
(   78)     }
|
[abe@gv100-ws ~]$ export NVCOMPILER_ACC_TIME=1
[abe@gv100-ws ~]$ nvc -acc -fast -Minfo=accel laplace2.c -o laplace2-C
main:
     51, Generating copy(A[:][:]) [if not already present]
         Generating create(Anew[:][:]) [if not already present]
while ループの前の明示的な A[] とAnew[] 配列のアロケート&コピー
     53, Generating implicit copy(error) [if not already present]
すでに存在しているため、コピー動作は行わない
     56, Loop is parallelizable
     58, Loop is parallelizable
         Generating NVIDIA GPU code
         56, #pragma acc loop gang, vector(128) collapse(2) /* blockIdx.x threadIdx.x */
             Generating implicit reduction(max:error)
         58,   /* blockIdx.x threadIdx.x auto-collapsed */
     67, Loop is parallelizable
     69, Loop is parallelizable
         Generating NVIDIA GPU code
         67, #pragma acc loop gang, vector(128) collapse(2) /* blockIdx.x threadIdx.x */
         69,   /* blockIdx.x threadIdx.x auto-collapsed */
|
実行性能を見てみよう。以下のように劇的に性能が向上したことが分かる。1.3 秒の経過時間で終了した。プロファイルの結果を見ても、データ移動にかかわる時間は、ほとんど無視できる程度までになり、経過時間のほとんどがアクセラレータ上における並列化処理に要した時間となっている。さらに性能を伸ばしたいのであれば、並列分割の方法を変更するといった OpenACC loop 構文を使ったチューニングを行うこととなる。
[abe@gv100-ws ~]$ ./laplace2-C
Jacobi relaxation Calculation: 4096 x 4096 mesh
    0, 0.250000
  100, 0.002397
  200, 0.001204
  300, 0.000804
  400, 0.000603
  500, 0.000483
  600, 0.000403
  700, 0.000345
  800, 0.000302
  900, 0.000269
 total: 1.371401 s

Accelerator Kernel Timing data
/home/abe/laplace2.c
  main  NVIDIA  devicenum=0
    time(us): 1,152,695
        58: kernel launched 1000 times
    51: data region reached 2 times  DATA 領域のプロファイル
        51: data copyin transfers: 8
             device time(us): total=10,961 max=1,379 min=1,368 avg=1,370
        78: data copyout transfers: 9
             device time(us): total=10,255 max=1,282 min=5 avg=1,139
    53: compute region reached 1000 times   計算領域のプロファイル
        58: kernel launched 1000 times
            grid: [65535]  block: [128]
             device time(us): total=512,223 max=515 min=504 avg=512
            elapsed time(us): total=524,195 max=544 min=517 avg=524
        58: reduction kernel launched 1000 times
            grid: [1]  block: [256]
             device time(us): total=111,657 max=128 min=107 avg=111
            elapsed time(us): total=123,380 max=149 min=119 avg=123
    53: data region reached 2000 times  DATA 領域のプロファイル
        53: data copyin transfers: 1000
             device time(us): total=2,273 max=17 min=2 avg=2
        64: data copyout transfers: 1000
             device time(us): total=5,505 max=14 min=4 avg=5
    64: compute region reached 1000 times   計算領域のプロファイル
        69: kernel launched 1000 times
            grid: [65535]  block: [128]
             device time(us): total=499,821 max=502 min=491 avg=499
            elapsed time(us): total=513,213 max=528 min=505 avg=513

[abe@gv100-ws ~]$ export NVCOMPILER_ACC_TIME=0
[abe@gv100-ws ~]$ nvprof ./laplace2-C
Jacobi relaxation Calculation: 4096 x 4096 mesh
==33269== NVPROF is profiling process 33269, command: ./laplace2-C
    0, 0.250000
  100, 0.002397
  200, 0.001204
  300, 0.000804
  400, 0.000603
  500, 0.000483
  600, 0.000403
  700, 0.000345
  800, 0.000302
  900, 0.000269
 total: 1.472973 s
==33269== Profiling application: ./laplace2-C
==33269== Profiling result:
            Type  Time(%)      Time     Calls       Avg       Min       Max  Name
 GPU activities:   44.67%  513.11ms      1000  513.11us  505.60us  517.47us  main_58_gpu
                   43.45%  499.10ms      1000  499.10us  491.74us  502.75us  main_69_gpu
                    9.83%  112.91ms      1000  112.91us  106.82us  128.00us  main_58_gpu__red
      API calls:   89.43%  1.13760s      4002  284.26us  1.3640us  1.2731ms  cuStreamSynchronize
                    7.10%  90.322ms         1  90.322ms  90.322ms  90.322ms  cuDevicePrimaryCtxRetain
                    1.21%  15.415ms         1  15.415ms  15.415ms  15.415ms  cuMemHostAlloc
OpenACC (excl):   50.78%  625.48ms      1000  625.48us  249.67us  636.58us  acc_wait@laplace2.c:58
                   40.76%  502.00ms      1000  502.00us  488.82us  517.33us  acc_wait@laplace2.c:69
                    2.85%  35.063ms         1  35.063ms  35.063ms  35.063ms  acc_enter_data@laplace2.c:51
                    2.00%  24.583ms         1  24.583ms  24.583ms  24.583ms  acc_exit_data@laplace2.c:51
(但し、1%未満の値のものについては省略した。)
|
• Fortran プログラムの場合
(   43) !$acc data copy(A), create(Anew) while ループの前の明示的な A[] とAnew[] 配列のアロケート&コピー
(   44)     do while ( iter .le. iter_max-1 .and. error .gt. tol )
(   45)
(   46)       error =0.d0
(   47) !$acc kernels
(   48)       do j = 2, m-1
(   49)         do i = 2, n-1
(   50)           Anew(i,j) = 0.25 * ( A(i,j+1) + A(i,j-1) &
(   51)                              + A(i-1,j) + A(i+1,j) )
(   52)           error = max(error, abs(Anew(i,j) - A(i,j)))
(   53)         end do
(   54)       end do
(   55) !$acc end kernels
(   56)
(   57) !$acc kernels
(   58)       do j = 2, m-1
(   59)         do i = 2, n-1
(   60)           A(i,j) = Anew(i,j)
(   61)         end do
(   62)       end do
(   63) !$acc end kernels
(   64)
(   65)       if ( mod (iter,100) == 0 ) print *, iter, error
(   66)       iter = iter + 1
(   67)
(   68)     end do
(   69) !$acc end data
|
[abe@gv100-ws ~]$ export NVCOMPILER_ACC_TIME=1
[abe@gv100-ws ~]$ nvfortran -acc -fast -Minfo=accel laplace2.f90 -o laplace2-F
laplace:
     43, Generating copy(a(:,:)) [if not already present]
         Generating create(anew(:,:)) [if not already present]  while ループの前の明示的な A[] とAnew[] 配列のアロケート&コピー
     47, Generating implicit copy(error) [if not already present] すでに存在しているため、コピー動作は行わない
     48, Loop is parallelizable
     49, Loop is parallelizable
         Generating NVIDIA GPU code
         48, !$acc loop gang, vector(128) collapse(2) ! blockidx%x threadidx%x
             Generating implicit reduction(max:error)
         49,   ! blockidx%x threadidx%x auto-collapsed
     58, Loop is parallelizable
     59, Loop is parallelizable
         Generating NVIDIA GPU code
         58, !$acc loop gang, vector(128) collapse(2) ! blockidx%x threadidx%x
         59,   ! blockidx%x threadidx%x auto-collapsed

[abe@gv100-ws ~]$ ./laplace2-F
 Time measurement accuracy : .10000E-05
 Jacobi relaxation Calculation:         4096  x          4096 mesh
            0   0.2500000000000000
          100   2.3970623764720811E-003
          200   1.2043203299441085E-003
          300   8.0370630064013904E-004
          400   6.0346074818462547E-004
          500   4.8300191812361559E-004
          600   4.0251372422966947E-004
          700   3.4514687472469996E-004
          800   3.0211701794469192E-004
          900   2.6855145615783949E-004
 total :     1.368893000000000      sec

Accelerator Kernel Timing data
/home/abe/laplace2.f90
  laplace  NVIDIA  devicenum=0
    time(us): 1,150,450
    43: data region reached 2 times    DATA 領域のプロファイル
        43: data copyin transfers: 8
             device time(us): total=10,960 max=1,377 min=1,367 avg=1,370
        69: data copyout transfers: 9
             device time(us): total=10,261 max=1,286 min=5 avg=1,140
    47: compute region reached 1000 times   計算領域のプロファイル
        49: kernel launched 1000 times
            grid: [65535]  block: [128]
             device time(us): total=507,802 max=512 min=501 avg=507
            elapsed time(us): total=519,947 max=563 min=513 avg=519
        49: reduction kernel launched 1000 times
            grid: [1]  block: [256]
             device time(us): total=114,955 max=130 min=108 avg=114
            elapsed time(us): total=126,770 max=144 min=119 avg=126
    47: data region reached 2000 times    DATA 領域のプロファイル
        47: data copyin transfers: 1000
             device time(us): total=2,386 max=6 min=2 avg=2
        55: data copyout transfers: 1000
             device time(us): total=5,633 max=20 min=4 avg=5
    57: compute region reached 1000 times   計算領域のプロファイル
        59: kernel launched 1000 times
            grid: [65535]  block: [128]
             device time(us): total=498,453 max=502 min=491 avg=498
            elapsed time(us): total=511,924 max=523 min=505 avg=511

[abe@gv100-ws ~]$ export NVCOMPILER_ACC_TIME=0
[abe@gv100-ws ~]$ nvprof ./laplace2-F
 Time measurement accuracy : .10000E-05
 Jacobi relaxation Calculation:         4096  x          4096 mesh
==33295== NVPROF is profiling process 33295, command: ./laplace2-F
            0   0.2500000000000000
          100   2.3970623764720811E-003
          200   1.2043203299441085E-003
          300   8.0370630064013904E-004
          400   6.0346074818462547E-004
          500   4.8300191812361559E-004
          600   4.0251372422966947E-004
          700   3.4514687472469996E-004
          800   3.0211701794469192E-004
          900   2.6855145615783949E-004
 total :     1.466196000000000      sec
==33295== Profiling application: ./laplace2-F
==33295== Profiling result:
            Type  Time(%)      Time     Calls       Avg       Min       Max  Name
 GPU activities:   44.48%  509.90ms      1000  509.90us  503.55us  520.89us  laplace_49_gpu
                   43.48%  498.37ms      1000  498.37us  491.90us  502.78us  laplace_59_gpu
                    9.99%  114.51ms      1000  114.51us  107.55us  129.73us  laplace_49_gpu__red
                    1.00%  11.426ms      1009  11.323us  1.1200us  1.2751ms  [CUDA memcpy DtoH]
      API calls:   89.85%  1.13538s      4002  283.70us  1.0310us  1.2737ms  cuStreamSynchronize
                    6.59%  83.289ms         1  83.289ms  83.289ms  83.289ms  cuDevicePrimaryCtxRetain
                    1.25%  15.837ms         1  15.837ms  15.837ms  15.837ms  cuMemHostAlloc
OpenACC (excl):   50.71%  623.82ms      1000  623.82us  225.49us  635.72us  acc_wait@laplace2.f90:49
                   40.75%  501.27ms      1000  501.27us  493.60us  515.36us  acc_wait@laplace2.f90:59
                    2.89%  35.592ms         1  35.592ms  35.592ms  35.592ms  acc_enter_data@laplace2.f90:43
                    2.02%  24.872ms         1  24.872ms  24.872ms  24.872ms  acc_exit_data@laplace2.f90:43
(但し、1%未満の値のものについては省略した。)
|
7. 性能のまとめ
OpenACC のプログラミングにおいては、ホスト~デバイス間の「データ転送を行う場所」をプログラム上で明示的に行うことが、性能を向上させるための重要なタスクとなっている。本章では、OpenACC data ディレクティブを活用し、データコピーを行う場所を指定することにより、ループ内部で必要のないデータ転送を避けることができることを示した。その結果、データの転送を最適化することにより大きな性能向上があることも理解できた。実際のプログラムはより複雑なものではあるが、ポーティングにおいては、段階的にディレクティブを挿入してみて、その実行結果を見ながら、順番に OpenACC 化を行っていくことが望ましい。以下に、今回のプログラムを使って性能がどのように変化したかを纏める。(ここでは四捨五入した値を示す。)
| 挿入ディレクティブの内容 | C (秒) | Fortran (秒) |
|---|---|---|
| (1) CPU上での1コア性能 | 57.6 | 51.9 |
| OpenMPスレッド並列(4コア並列) | 18.3 | 15.2 |
| CPU+GPU アクセラレータを使用した性能 | ||
| (2) OpenACC のループ並列化用ディレクティブ挿入 | 114.3 | 113.2 |
| (3) OpenACC のデータ・ディレクティブも挿入 | 1.4 | 1.4 |
参考(PGIコンパイラ/Corei7 2.67GHz 4core/GPU Kepler K20c/CUDA 5.5)
| 挿入ディレクティブの内容 | C (秒) | Fortran (秒) |
|---|---|---|
| (1) CPU上での1コア性能 | 131.9 | 73.5 |
| OpenMPスレッド並列(4コア並列) | 52.0 | 53.1 |
| CPU+GPU アクセラレータを使用した性能 | ||
| (2) OpenACC のループ並列化用ディレクティブ挿入 | 168.1 | 120.3 |
| (3) OpenACC のデータ・ディレクティブも挿入 | 5.1 | 5.1 |
おわりに
ソフテックから引き継いだPGIコンパイラでのOpenACC利用事例を新しいNVIDIA HPC SDK で確認し、GPUの進歩により 従来のOpenACC対応したアプリケーションをそのまま利用してカーネルループの従来のGPUよりもさらに性能が高速化されることが確認できました。今後 その他の GPU利用技術をNVIDIA HPC SDKで確認して行きたいと思います。
お楽しみに。